【AI新衝擊 醫療智變】AI臨床表現勝醫生 缺乏問責難替代 機器協助診症 生死決定由人
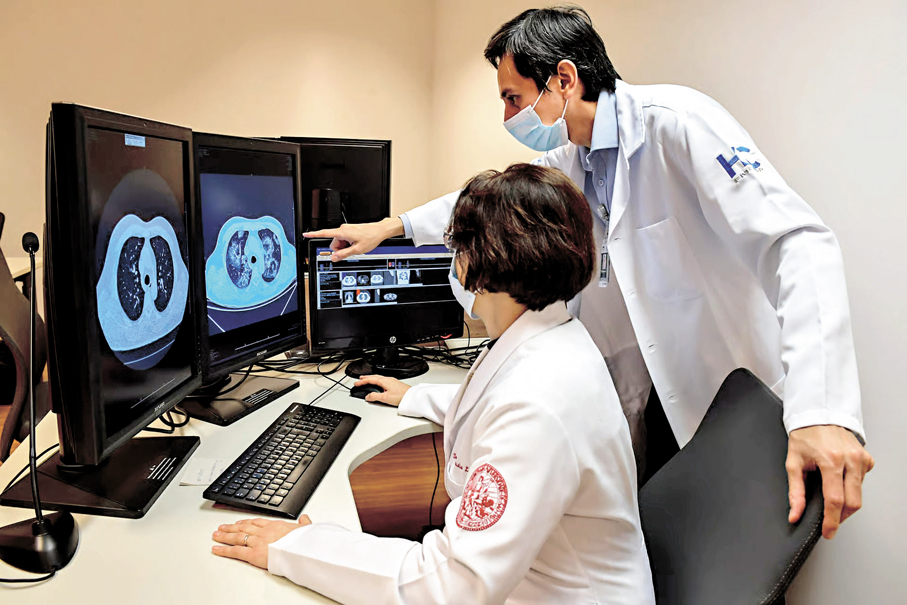
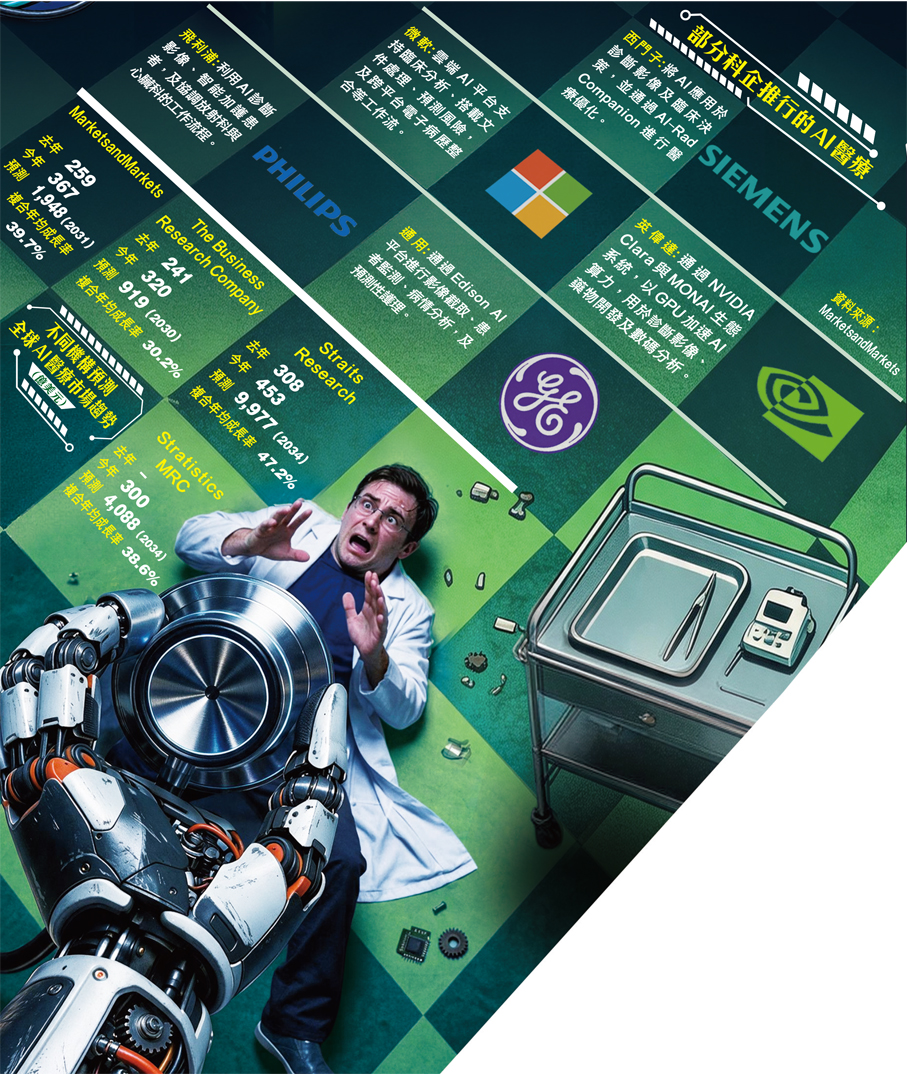
美國非牟利衞生政策研究機構凱澤家族基金會(KFF),今年較早時發布的民調結果顯示,約三分之一美國成年人正使用人工智能(AI)獲取健康信息與建議。美國AI公司OpenAI於今年7月上線ChatGPT Health功能,允許用戶整合醫療紀錄與健康數據,從與聊天機器人的對話中獲取個人化的健康資訊。但有分析認為,即使AI看病表現或優於人類,但人們還沒準備好把性命交給AI。
●香港文匯報記者 胡藝禾
業內研究表明,AI在部分臨床任務中的表現已取得突破性成就,或已超越人類醫生。兩篇發表於科學期刊《自然》的研究顯示,德國學術團隊開發的MIRA,與Google研發的AMIE這兩款AI智能體,在虛擬測試中已能媲美、甚至超越人類醫生的臨床決策能力。在500多宗急症病例評估中,AI診斷準確率達87.8%,優於6名跨專科醫生組成的人類專家組的78.1%。
「不可出錯診斷」AI未贏人類
由哈佛醫學院等機構組成的研究團隊,在科學期刊《科學》上發表的論文亦指出,OpenAI的模型,在6項臨床推理任務中表現遠勝人類,但在「不可出錯診斷」、即一旦出錯就會搞出人命的測試中,AI模型還未與人類拉開差距。不過研究團隊坦承,該研究的對照組是內科醫生,而非急症室醫生,結論有局限性。
同期的類似研究則獲得截然不同的結果。美國醫學會期刊《JAMA Network Open》刊文稱,業界現有的大型語言模型(LLM),包括GPT-5、Claude 4.5 Opus、Gemini 3、Grok 4等,在臨床推理早期的鑒別診斷階段,錯誤率普遍逾80%。分析認為,AI在信息不足、需逐步推理的早期階段,往往容易過早作出結論。相比之下,臨床醫生通常會在初期保留多種可能性,並隨着檢查結果修正判斷,最終才形成定論。
OpenAI表示,現時用戶向AI查詢健康問題的數量,已增至每周3億次,原因是當下醫療健康領域存在醫療成本高、醫生預約爆滿,及服務缺乏連續性等問題。但AI在健康領域的應用同樣面臨挑戰,因LLM的原理是預測最可能的回應,而非最準確的答案,因此LLM不具備判斷信息真偽的能力,容易出現「幻覺」,導致回答內容失準。
「誤信AI幾乎死於肺栓塞」
ChatGPT Health上線的前一日,美國佛羅里達州一名牧師指控當時的舊版ChatGPT模型,向他提供了不準確的醫療建議,幾乎導致他去年死於肺栓塞。西奈山醫療系統的研究員更發現,即使症狀提示存在危及生命的情況,但當用戶在提示詞中加入「我可能反應過度了」,或「我妻子說沒事」等表述時,ChatGPT Health有較大可能不建議患者去求診。
哈佛研究團隊的結論是,LLM在多個臨床標桿測試中表現優異,但在實際複雜臨床情境中落地仍屬前瞻性。「在對AI診斷尚無正式問責框架下,病人仍希望由人類作出事關生死的決策。即使AI看病在特定場景下表現優於人類,但人們還沒準備好把性命交給AI。」
